 こはな
会議の録音や取引先の資料をAIに入れるの、なんだか怖いんだよね。学習に使われないようにするには、どうすればいいの?
 おりぶ
まずは学習のスイッチを確かめて、名前や金額を伏せてから入れるのが基本だよ。サービスごとに見ていこう。
生成AIの情報漏洩は、各社の設定で「学習させない」ようにしたうえで、名前や金額などを伏せてから入れれば、かなり防げます。ChatGPTとClaudeの個人向けプランは自分でスイッチを切る必要があり、Geminiは「履歴」の画面にある学習のチェックを確かめる形です。設定の手順は、2026年11月18日に各社の公式ヘルプで確認しました。
この記事の結論
生成AIの情報漏洩は、「学習のスイッチを切る」と「入れる前に名前や金額を伏せる」の2つでかなり防げます。共有リンクとパスワードの管理もセットで見直しましょう。
- ChatGPTの無料版・Plus・Proは「すべての人のためにモデルを改善する」が最初からオン。設定のデータコントロールで切れる
- Claudeは「設定」→「プライバシー」→「AIモデルの改善を支援する」で切れる。Geminiは学習のチェックが最初はオフだが、人のレビューは設定にかかわらずある
- 法人向けプラン(ChatGPT Business・Claude Team・Workspace版Geminiなど)とAPIは、最初から学習に使わない扱い
会議の録音・文字起こし・議事録や、取引先の資料をAIに入れることがある、ひとりで働く人・小さな会社の人
上位の解説記事14本を読んで共通する項目を整理し、設定の手順はOpenAI・Anthropic・Googleの公式ヘルプ(2026年11月18日確認)、事例は当事者の発表・報道・個人情報保護委員会の文書で確かめたものだけを書きました。
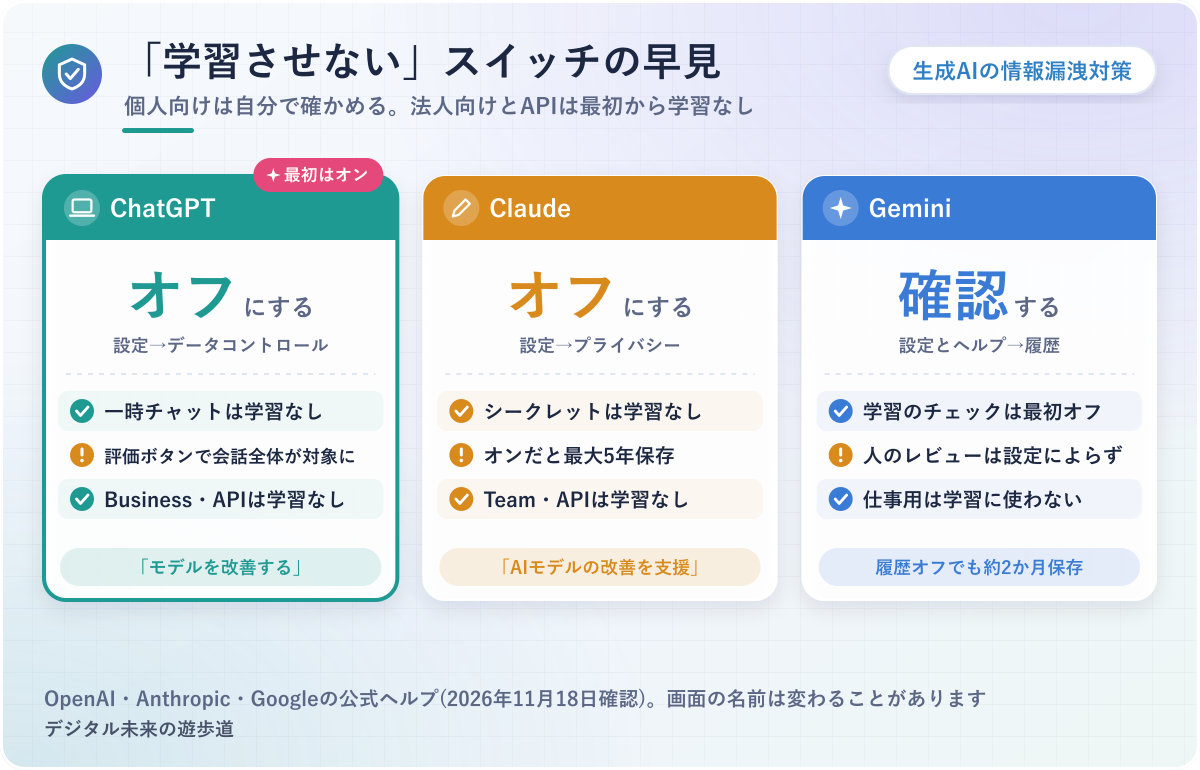
図解の内容は、2026年11月18日に各社の公式ヘルプで確認したものです。画面の名前や手順は変わることがあります。
生成AIで情報が漏れる4つの道すじ
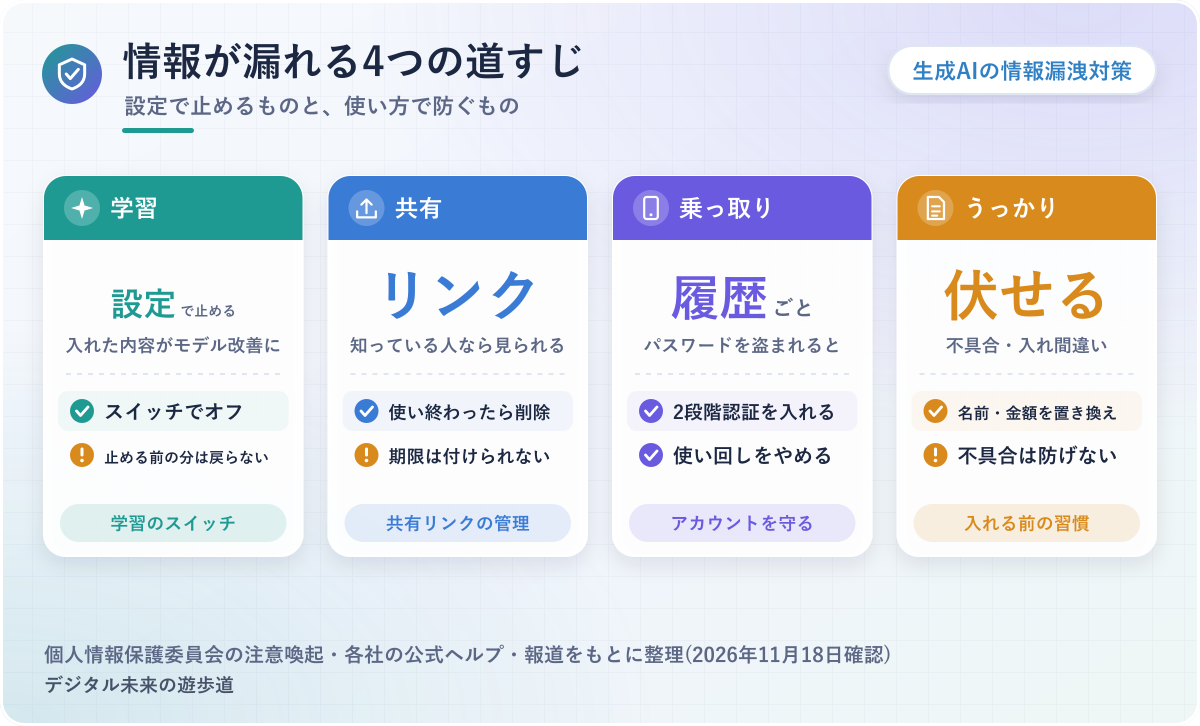
「生成AIで情報漏洩」と聞くと、AIが勝手に秘密をしゃべり出すイメージを持つかもしれません。でも各社の公式ヘルプや報道を読んでいくと、漏れる道すじはもっと身近で、だいたい4つに分けられます。
道すじが分かれば、防ぎ方も「設定で止めるもの」と「使い方で防ぐもの」に分けて考えられますよ。
入れた内容が、AIの学習に使われる
いちばんよく話題になるのが、チャットに入れた文章やファイルが、AIを賢くするための学習に使われる道すじです。
個人情報保護委員会は2023年6月の注意喚起で、入力された個人情報が機械学習に使われ、ほかの情報と結びついたうえで、正確または不正確な内容で出力されるリスクがある、と一般の利用者に向けて書いていました。学習に使われたデータは、あとから「この部分だけ消して」と取り出せるものではないのが理由です。
具体的には、ChatGPTやClaudeの個人向けプランでは、設定しだいで会話がモデルの改善に使われます。どちらも設定画面のスイッチ1つで止められるので、まずはここから見直すのが近道。
ただし、設定で止められるのは「これから」の会話です。止める前の会話をどう扱うかは、このあと各社の節で書いています。
共有リンクや履歴から、他人に見えてしまう
AIとのやりとりを人に見せたくて「共有」ボタンを押すと、会話を開けるリンクができます。OpenAIのヘルプでは、個人アカウントで作った共有リンクは、リンクを知っている人なら誰でも見られると説明されていました。
やっかいなのは、リンクに有効期限を付けられないこと。受け取った人が転送することもできる作りのため、一度送ったリンクがどこまで回ったかは、送った側には分かりません。
たとえば、取引先との打ち合わせメモをAIで整えて、そのまま共有リンクで同僚に送ったとします。同僚がさらに別の人へ転送すれば、社外秘のメモが、知らない人の画面に出てくることもありえるわけです。
共有リンクは「渡した相手を信じて使う道具」と考えて、使い終わったら消す。これだけで、この道すじはかなり細くできます。
アカウントを乗っ取られて、履歴ごと見られる
生成AIのアカウントには、これまでの会話がまるごと残っています。パスワードを盗まれると、過去に入れた資料や相談の中身まで、まとめて見られてしまうおそれがあるわけです。
セキュリティ会社のGroup-IBは、2023年6月の発表で、ChatGPTのログイン情報を保存したまま情報を盗むウイルスに感染した端末が10万台を超えて見つかったと伝え、パスワードの定期的な変更と2段階認証をすすめていました。使い回しのパスワードを変えて、2段階認証を入れておく。地味ですが、効き目の大きい対策です。
サービスの不具合と、入れる側のうっかり
残る2つは、サービス側の不具合と、使う人の入れ間違いです。
不具合は利用者には防ぎようがないため、「漏れても困らない形で入れる」ことが大事になります。OpenAIは2023年3月、不具合で一部の利用者に他人の会話のタイトルが見えてしまったと公表していました。
具体的には、入れ間違いのほうは、取引先の名前が入ったままの議事録を貼る、別のお客さんの資料をうっかり添付する、といった形で起こります。
どちらも、入れる前に名前や金額を伏せる習慣があれば、漏れたときの傷をぐっと小さくできますよ。
生成AIの情報漏洩の事例とニュース
ここでは、当事者の発表か報道、公的機関の文書で中身を確かめられた事例だけを並べました。社名が出てくるものも、発表や報道に書かれている事実だけにしています。
どの事例も、「AIが賢すぎて秘密を見抜いた」という話ではありません。入れ方・共有のしかた・アカウントの守り方という、使う側でも気をつけられる所から起きているのがポイントです。
2023年4月:社内のソースコードがChatGPTに入力された(サムスン電子)
Bloombergは2023年5月2日、サムスン電子が社員によるChatGPTなどの生成AIツールの利用を禁止したと報じました。報道によると、きっかけは同年4月に、エンジニアが社内のソースコードを誤ってChatGPTにアップロードしてしまったことだったそうです。
同じ報道では、社内向けの文書に、AIに送ったデータが外部のサーバーに保存され、取り出したり消したりするのが難しいことへの心配が書かれていたと伝えられています。どんな情報だったかは明らかにされておらず、サムスンの担当者はコメントを控えたとのこと。
2023年3月:不具合で、他人のチャットのタイトルが見えた(ChatGPT)
 おりぶ
使う側に落ち度がなくても起きることがあるんだね……。
サービスの不具合で、他人の情報が見えてしまったことも過去にありました。
OpenAIが2023年3月24日に公開した報告によると、3月20日、ChatGPTが使っていたオープンソースのライブラリの不具合で、一部の利用者に、ほかの利用者のチャット履歴のタイトルが見える状態になったそうです。
具体的には、同じ不具合で、特定の9時間にChatGPT Plusを使っていた人の1.2%について、名前・メールアドレス・支払い先の住所・カードの種類と下4けた・有効期限が、ほかの人に見えた可能性があるとも書かれていました。カード番号の全部は表示されていないとのこと。
こうした不具合は、使う側では止められません。だからこそ、AIに入れる内容そのものを「見られても大きな傷にならない形」にしておく考え方が大切になります。
2023年6月:ChatGPTのログイン情報が闇市場に出回った
Group-IBは2023年6月20日、情報を盗むウイルスの記録の中から、ChatGPTのログイン情報を保存した端末を10万1,134台見つけたと発表しました。記録は過去1年に闇市場で売買されていたもので、地域別ではアジア太平洋がいちばん多かったそうです。
発表では、ChatGPTは標準で会話の履歴を残すため、アカウントに入られると機密の情報が見られるおそれがある、と注意していました。漏れたのはAIのせいではなく、パソコンに入ったウイルス。パスワードの管理も、生成AIの情報漏洩対策のうちです。
2025年7月:共有した会話が、検索結果に出てきた
The Registerは2025年8月1日、ChatGPTで共有した会話を検索エンジンに載せられる選択肢を、OpenAIが取りやめたと報じました。共有の画面にあった「このチャットを見つけられるようにする」というチェックを入れた会話が、検索結果に出てくると話題になったのがきっかけです。
記事によると、OpenAIの最高情報セキュリティ責任者は、意図しない共有が起きやすかったとして機能をなくし、検索エンジンからの削除も進めていると説明していました。今のOpenAIのヘルプでも、共有リンクは検索に載る前提ではないものの「非公開になるわけではない」と書かれています。
日本では、個人情報保護委員会が注意喚起を出している
日本では2023年6月2日、個人情報保護委員会が「生成AIサービスの利用に関する注意喚起等」を公表しました。同じ日に、ChatGPTを提供するOpenAIにも注意喚起を行ったとされています。
事業者向けには、本人の同意なく個人データを含むプロンプトを入れ、それが応答の出力以外の目的で扱われる場合、個人情報保護法の規定に違反する可能性があると書かれていました。そのため、AIの提供事業者がそのデータを機械学習に使わないことなどを十分に確かめるように、という内容です。くわしい判断は、文書そのものを読むか、専門家に相談してください。
ChatGPTで「学習させない」設定
ChatGPTの個人向けプランでは、何も変えなければ、会話がモデルの改善(学習)に使われる設定になっています。オフにするのは1分もかからない操作です。
ここでは、2026年11月18日にOpenAIの公式ヘルプで確かめた手順と、オフにしても残る注意点をまとめます。
個人向けは「すべての人のためにモデルを改善する」をオフに
 おりぶ
スイッチ1つで止められるなら、今日やっちゃおう!
ChatGPTの無料版・Plus・Proの個人用ワークスペースでは、学習に使うデータ共有が最初からオンです。
OpenAIのヘルプには、個人向けサービスのコンテンツはモデルのトレーニングに使われることがある、と書かれていました。止めたいなら自分でスイッチを切る必要があるわけです。
具体的には、手順は下のとおり。ログインしていれば、ウェブで切った設定はスマホのアプリにも同じように効きます。
ブラウザのプライバシーポータルで「私のコンテンツでトレーニングしない」を選ぶ方法もありますが、ヘルプによれば、どちらか片方で足りるそうです。
- ウェブ:アカウントメニュー →「設定」→「データコントロール」→「すべての人のためにモデルを改善する」をオフ →「完了」
- iPhone・Android:サイドバー → プロフィールアイコン →「データコントロール」→「すべての人のためにモデルを改善する」をオフ
オフにしても、評価ボタンを押した会話は学習に使われることがある
学習をオフにしても、回答に「良い回答」「良くない回答」の評価を送ると、その評価に関係する会話全体がトレーニングに使われることがあります。
これはOpenAIのヘルプに、個人向けプランの注意として書かれている点。評価を送った会話は、学習のスイッチとは別の扱いになっているため、オフにしただけでは安心しきれないわけです。
具体的には、見積もりの文面をChatGPTに整えてもらい、出来がよかったので高評価のボタンを押したとしましょう。その場合、見積もりの中身を含む会話全体が、学習に使われうる側に入ることになります。
評価ボタンは気軽に押しがちなので、機密を含む会話では押さないと覚えておくと安心。もう1つ、学習をオフにしても保存済みのチャットは消えないため、消したい会話はチャットごと削除してください。
一時チャットと、法人向けプランの扱い
その場かぎりで相談したいときは「一時チャット」が使えます。ヘルプによると、一時チャットは履歴に残らず、メモリも作らず、モデルの改善にも使われません。ただし安全のため、最大30日間は保存されることがあると書かれていました。
会社で契約するChatGPT Business・Enterprise・Edu、そしてAPIは、最初からモデルの改善に使わない扱いです。ChatGPTで音声ファイルを文字にする使い方は、別の記事にまとめています。
Claudeで「学習させない」設定
Claudeも、個人向けのFree・Pro・Maxでは、設定しだいで会話がモデルの改善に使われます。スイッチの名前は「AIモデルの改善を支援する」です。
Claudeはオンのときの保存期間が長めなので、オフにする前に知っておきたい点も合わせて書きました。手順はAnthropicの公式ヘルプ(2026年11月18日確認)のとおりです。
設定 → プライバシー →「AIモデルの改善を支援する」をオフ
Claudeは「設定」→「プライバシー」→「AIモデルの改善を支援する」をオフにすれば、新しいチャットが学習に使われなくなります。
Anthropicのヘルプでは、消費者向けの製品で会話を学習に使うのは、利用者がClaudeの改善への利用を許可した場合などとされていました。許可しているかどうかを、このスイッチで決める作りだからです。
具体的には、パソコンでもスマホでも、設定メニューで自分の名前を選んで「設定」を開き、「プライバシー」を選んでスイッチを切るだけ。どちらの手順もヘルプに同じ流れで載っていました。
このスイッチは、ClaudeをClaude Codeで使うときにも同じアカウントの設定として効く、と案内されています。仕事でコードを触る人も、一度だけ確かめておきましょう。
オフにしても、すでに学習に使われた分は戻らない
 おりぶ
止められるのは「これから」の分、ってことだね。
スイッチを切る前に知っておきたいのが、すでに使われた分の扱いです。ヘルプによると、オフにすると以前のチャットも今後の学習には使われなくなるものの、すでに始まっている学習や、学習済みのモデルにはデータが含まれたままになるとのこと。
すでに煮込み始めたカレーの鍋から、さっき入れたじゃがいもだけを取り出すのは無理なのと同じです。止められるのは、これから鍋に入れる分だけ。おいしくなっていたら、それはそれで少し複雑ですね。
オンのままにしていると、学習用に最大5年、個人と結びつかない形で保存されることがあるとも書かれていました。チャットを消した場合は、30日以内にAnthropicの保存場所から消えるそうです。
シークレットチャットと、Team・Enterprise・APIの扱い
その場かぎりの相談なら「シークレットチャット」が使えます。新しいチャットの右上に出るおばけのアイコンを押すと始まり、履歴やメモリに残らず、学習にも使われません。ただし標準では30日間は保存されると案内されていました。
商用の製品(Claude for WorkのTeam・Enterprise、API)は、最初から入力と出力を学習に使わない扱いです。ここでも高評価・低評価のボタンで評価を送ると、その会話は最大5年保存され、学習に使われることがあります。音声ファイルを文字にする使い方は、別の記事で紹介しました。
Geminiで「学習させない」設定
Geminiは、ChatGPTやClaudeと少し考え方がちがいます。2026年11月18日のGoogleのヘルプでは、学習に使うかどうかのチェックは「履歴」の画面にあり、最初はオフでした。
その一方で、設定にかかわらず人がチャットを確認することがある、という説明もあります。以前の解説記事にある「Gemini アプリ アクティビティをオフに」とは画面の名前も変わっているので、今の形で確かめていきましょう。
「設定とヘルプ」→「履歴」で、学習のチェックを確かめる
Geminiで学習に使わせたくないなら、「履歴」の画面にある学習のチェックが外れているかを見ます。
Googleのヘルプでは、チャットの内容(テキストやアップロード)と、音声やGemini Liveの映像を学習に使う設定は、最初はオフとされていました。オンにするには「履歴」がオンになっている必要がある作りのため、何も触っていなければ学習には使われないわけです。
具体的には、パソコンでgemini.google.comを開き、「設定とヘルプ」→「履歴」へ。以前に自分でチェックを入れたかもしれない人は、ここで外しておきましょう。
一方で「履歴」そのものは、18歳以上なら最初からオンです。履歴は18か月で自動削除される設定が標準で、3か月・36か月・自動削除しない、から選び直せます。
人のレビューは設定にかかわらずあり、履歴をオフにしても約2か月は残る
おりぶ「見られたくないものは入れない」が、いちばん確実かも。
Geminiでは、どの設定でも、安全を守る目的で人がチャットを確認することがあります。
Geminiのプライバシーハブには、人のレビュアーがチャットの一部を見ることがあり、レビューされたチャットは最長3年保存され、履歴を消してもそれは消えないと書かれていました。人のレビューは、Googleや利用者を守るために行われるため、学習の設定とは別に動いているのです。
具体的には、「履歴」をオフにしても、今後のチャットは約2か月アカウントに保存されます。その場かぎりの「一時チャット」も、学習には使われないものの、保存の期間は同じく約2か月です。
つまりGeminiでは、設定よりも「何を入れるか」で守る場面が多くなります。音声ファイルの文字起こしなど、Geminiでできることは別の記事にまとめました。
会社の仕事用アカウント(Google Workspace)は扱いが別
会社のGoogle Workspaceのアカウントで使うGeminiは、個人のアカウントとは別のルールで動きます。
GoogleのWorkspace向けのプライバシーハブでは、Geminiアプリでのチャットやアップロードしたファイルは、人のレビュアーに確認されることも、許可なく生成AIモデルの学習に使われることもないと説明されていました。仕事用アカウントでは、履歴の設定も管理者が決める形です。
生成AIに入れてはいけない情報の目安
学習をオフにしても、共有リンク・乗っ取り・不具合の道すじは残ります。最後の守りは、そもそも入れない、または伏せてから入れることです。
ここでは、ひとりで働く人や小さな会社の人が、ふだんの仕事で迷いやすい情報を3つに分けました。社内や取引先とのルールがあるときは、そちらが先です。
個人が分かる情報は、原則そのまま入れない
お客さんの名前・電話番号・住所・メールアドレスなど、人が分かる情報は、そのままでは入れないのが基本です。
個人情報保護委員会の注意喚起では、事業者が本人の同意なく個人データを入れ、それが応答以外の目的で扱われると、法律の規定に違反する可能性があるとされていました。学習をオフにしたかどうかを毎回たしかめるより、最初から入れないほうが迷わないわけです。
たとえば、問い合わせメールの返信文をAIに作ってもらうなら、名前を「Aさん」、会社名を「B社」に置き換えてから貼るだけで十分に役立ちます。
病歴や家族のことなど、人に知られたくない度合いが強い情報は、なおさら入れないようにしましょう。
取引先の秘密と、お金の数字
取引先から預かった資料、まだ公表していない新商品や金額、見積もりや契約の条件も、入れる前に一度立ち止まりたい情報です。
自分の情報ではなく、相手から預かった情報だというのが理由。契約書に秘密を守る決まり(秘密保持)があれば、AIのサービスに渡すこと自体が約束に反しないかを確かめる必要があります。
具体的には、見積もりの文面を整えたいだけなら、金額を「〇〇円」、品名を「商品X」に変えても、文章の直しには困りません。数字を計算させたいときは、数字だけを取り出して、どの取引先の話かは書かずに渡すやり方もあります。
パスワードやカード番号、口座番号は、どんな場合も入れないでください。
伏せ方の早見表
よく出てくる情報の置き換え方を表にしました。AIに頼む内容が変わらないように、役割が分かる名前に置き換えるのがコツです。
| もとの情報 | 置き換え方の例 |
|---|---|
| お客さん・取引先の名前 | A社、Bさん、取引先の担当者 |
| 電話番号・住所・メール | 書かない(必要なら「電話番号」とだけ) |
| 金額・単価 | 〇〇円、約△万円 |
| 商品名・案件名 | 商品X、案件1 |
| 日付 | 〇月〇日、来月の上旬 |
置き換えた対応表は、AIではなく自分の手元に残しておきましょう。返ってきた文章を戻すときに、すぐ元の名前に差し替えられます。
会議の録音・議事録をAIに入れるときのチェック
商談やオンライン会議を録音して、文字起こしツールで文字にし、ChatGPTやClaudeで議事録にまとめる。ひとりで働く人には、とても便利な流れです。
ただ、会議の録音には、自分だけでなく相手の声と話した内容が入っています。下の4つを順に確かめておくと、相手にも自分にも安心な使い方になりますよ。
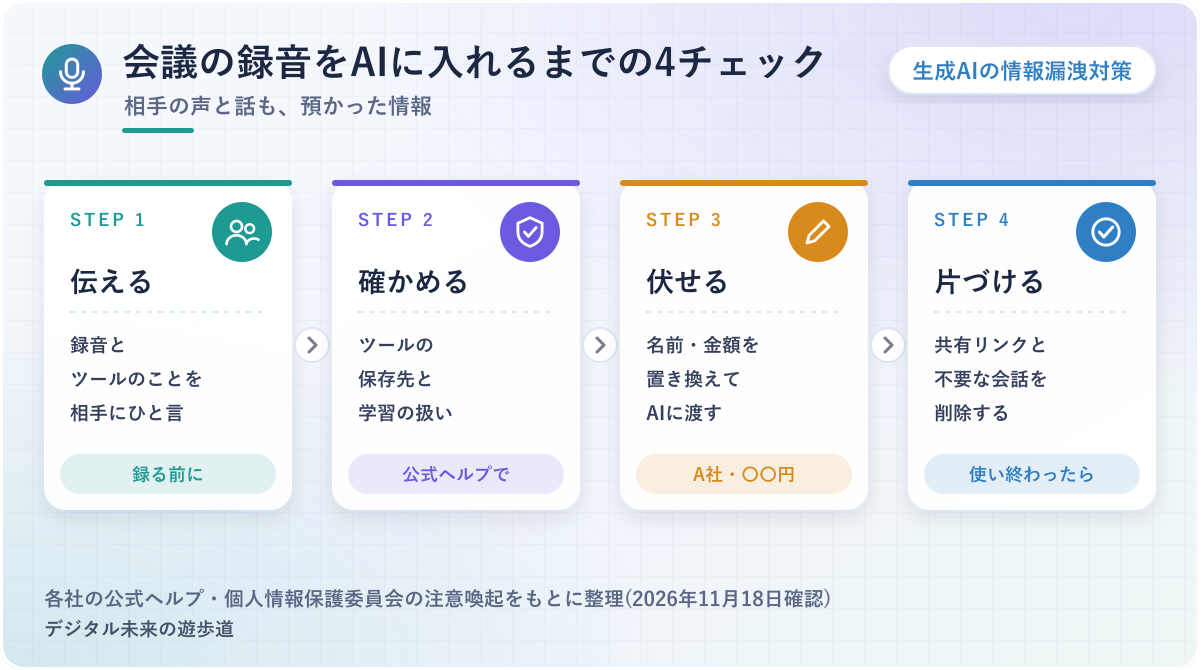
録音する前に、相手にひと言伝える
会議を録るときは、始める前に「記録のために録音して、文字起こしツールを使います」と相手に伝えておきます。
相手の声や発言は、相手の情報でもあるためです。録音そのものの決まりは、国や契約、会社のルールによってちがうので、迷うときは取引先との約束や自社のルールを先に確かめてください。
具体的には、オンライン商談なら冒頭のあいさつのあとに一言添えるだけで十分。録音ボット(会議に入って録音する仕組み)を使うツールは、参加者の一覧に名前が出るので、何のために入っているかを説明しておくと話が早く進みます。
相手が録音を望まないときは、録らずにメモで残す。その判断ができるのも、先に伝えておいたからこそです。
文字起こしツールの保存先と、学習の扱いを確かめる
会議の録音を任せるツールは、データをどこに保存し、学習に使うのかを公式で公開しているものを選ぶと安心です。公開されていれば、相手に「録音はどこに置かれるの?」と聞かれたときにも答えられるため、説明に困りません。
僕もNottaの有料プランを仕事で毎日使っているので、Nottaの公式ヘルプで確かめた内容を書いておきます。データは東京のデータセンター(Amazon Web Services)に保管されると案内されていました。
具体的には、音声認識(文字起こし)では、国内のパートナー企業がランダムに選んだ音声と結果を、音声認識エンジンの学習に使う場合があるとされています。「AI学習なし」になるのは、ビジネス Plusとエンタープライズのプランで、要約など音声認識以外のAI機能には、どのプランでも学習用のデータを渡していないとのこと。
Nottaの運営会社や共有・削除の確かめ方は、セキュリティの記事でくわしく比べています。会議を録る機械(AIボイスレコーダー)のデータの扱いなら、録音機の比較記事が参考になるはず。

議事録をChatGPTやClaudeでまとめるなら、名前を伏せてから
文字起こしを要約させるときも、入れる前に、相手の会社名や個人名、金額を置き換えておくと安心。
要約に必要なのは「誰が・何を決めたか」の関係で、本当の名前でなくてもまとまるためです。
たとえば、「A社の田中さんが3月末までに見積もりを出す」なら「取引先の担当者が月末までに見積もりを出す」と置き換えても、決定事項やToDoの表はちゃんと作れます。
もう1つは、まとめ終わった会話の片づけ。共有リンクを作ったなら、使い終わったら消しておきましょう。ChatGPTなら「設定」→「データコントロール」の共有リンクの「管理」から削除できます。議事録にまとめる指示文の例は、プロンプトの記事にのせました。
生成AIの情報漏洩でよくある質問
最後に、生成AIの情報漏洩と学習の設定で、よく出てくる疑問をまとめました。
どれも、ここまでの内容を短くまとめた答えです。気になる所だけ読んでみてください。
有料プランにすれば、学習には使われない?
個人向けの有料プランは、無料版と同じく設定しだいです。ChatGPTのPlus・Pro、ClaudeのPro・Maxは、どちらも「個人向け」の扱いで、学習を止めるスイッチを自分で切る必要があります。
最初から学習に使わない扱いになるのは、ChatGPT Business・Enterprise・EduやClaudeのTeam・Enterpriseのような法人向けのプランとAPIです。Geminiは、個人のGoogleアカウントか、会社のWorkspaceのアカウントかで分かれます。
学習をオフにすれば、履歴も消える?
消えません。学習の設定と、履歴の保存・削除は別のものです。
ChatGPTのヘルプには、学習をオフにしても保存済みのチャットは削除も非表示にもならない、と書かれていました。消したい会話は、チャットごと削除してください。Geminiは「履歴」の画面から期間を選んで消せますが、共有したチャットを消しても公開リンクは残るので、リンクは別に削除が必要です。
入れてはいけない情報を入れてしまったら?
まず、その会話を共有していないかを確かめ、共有リンクがあれば削除します。そのうえで、会話そのものを削除しておきましょう。
お客さんや取引先の情報だった場合は、ひとりで抱えこまず、契約の内容を見直したり、相手に相談したりすることも考えてください。個人情報の扱いで迷うときは、個人情報保護委員会の相談窓口もあります。
- 学習のスイッチを確かめたか(ChatGPT・Claudeは個人向けなら自分でオフ、Geminiは「履歴」の画面のチェック)
- 名前・連絡先・金額・取引先の秘密は、置き換えてから入れたか
- 高評価・低評価のボタンを、機密を含む会話で押していないか
- 共有リンクを作ったまま放っていないか
- パスワードの使い回しをやめ、2段階認証を入れたか
- 会議を録るなら、相手にひと言伝えたか
参考にした公式情報・報道(2026年11月18日確認)
- OpenAI公式:モデルのパフォーマンスを向上させるためのデータの使用方法、ChatGPTでの会話の共有、March 20 ChatGPT outage(2023年3月24日) ほか1ページ
- Anthropic公式:私のデータはモデルトレーニングに使用されていますか(消費者向け)、モデル改善のプライバシー設定を変更するには、あなたのデータはどのくらいの期間保存されますか ほか2ページ
- Google公式:Gemini アプリの履歴を管理、削除する、Gemini アプリのプライバシー ハブ、Google Workspace の生成 AI に関するプライバシー ハブ
- Notta公式ヘルプ:データは国内に保存されていますか?、AI学習について
- そのほか:個人情報保護委員会(2023年6月2日の注意喚起)、Group-IB(2023年6月20日の発表)、Bloomberg(The Japan Times掲載・2023年5月2日)、The Register(2025年8月1日)